


交叉验证
更新时间:2022-01-25
简介:
- 交叉验证(Cross Validation) 是在机器学习建立模型和验证模型参数时常用的方法。顾名思义,就是重复的使用数据,把得到的样本数据进行切分,组合为不同的训练集和验证集。用训练集来训练模型,验证集来评估模型的好坏。在此基础上可以得到多组不同的训练集和测试集,某次训练集中的样本,在下次可能成为测试集中的样本,也就是所谓的交叉。
- 交叉验证用在数据量不是很充足的情况(比如数据量小于一万条),能够从有限的数据中获取尽可能多的有效信息。
- 交叉验证用于评估模型的预测性能,尤其是训练好的模型在新数据上的表现,能够一定程度上减小过拟合。
交叉验证常用方法
留出法交叉验证
- 留出法 (Hold-Out Cross Validation) 是一种简单交叉验证,即针对原始数据集,通常分为训练集、验证集。训练集用于训练模型、验证集对于模型来说是未知数据,用于评估模型的泛化能力。比如我们随机的将样本数据分为两部分(80%的训练集,20%的验证集),然后用训练集来训练模型,验证集上验证模型及参数,最后选择损失函数评估最优的模型和参数。
k折交叉验证(文心中使用这种方法)
-
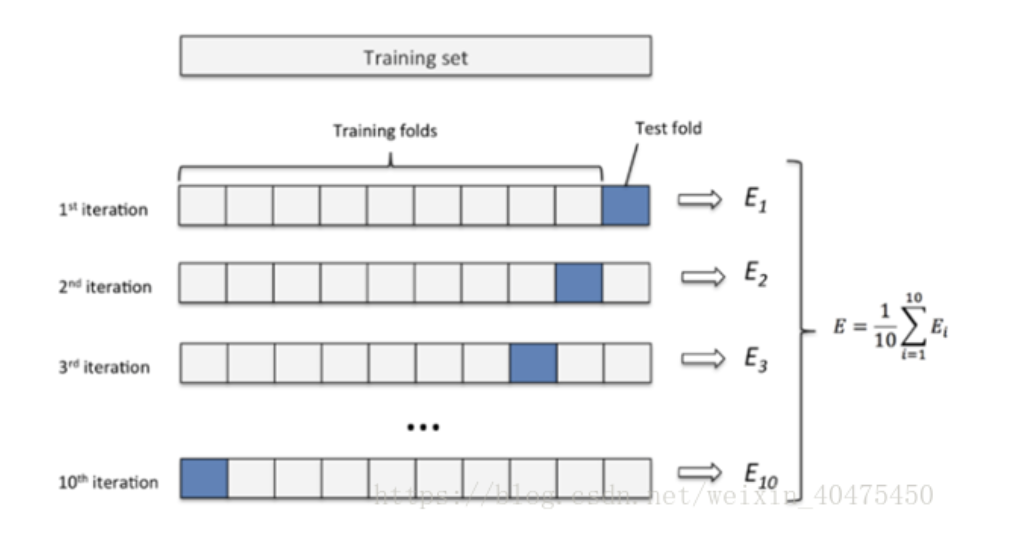
k折交叉验证 (k-fold Cross Validation) 过程如下所示:
- 不重复抽样将原始数据随机分成k份。
- 每次挑选其中1份作为验证集,剩余k-1份作为训练集用于训练模型。
- 重复第2步k次,在每个训练集上训练后得到一个模型。用这个模型在相应的验证集上测试,计算并保存模型的评估指标。
在文心中使用交叉验证
-
json配置
- "dataset_reader"中的"k_fold"相关参数为K折交叉验证的配置,num_fold表示需要将训练集拆成K折(num_fold的取值需要>=2),num_use_split表示被拆成K折,并组成K个训练集+验证集的数据集合中,有几个用来训练模型(num_use_split的取值不能大于num_fold)。data_path表示需要被拆分的原始数据集路径,必须是目录。data_path_split表示使用K折交叉验证拆分完成之后的数据存放路径,必须是个目录。
- 如下所示,以CNN分类任务为例:
{ "dataset_reader": { "k_fold": { "num_fold": 4, "data_path": "./data/train_data", "data_path_split": "./data_tmp", "num_use_split": 4 }, ... }, "model": { "type": "CnnClassification", "optimization": { "learning_rate": 2e-5 }, "vocab_size": 33261, "num_labels": 2 }, ... } -
启动入口
- 以CNN分类任务为例:
- 启动命令:sh normal_start_with_preprocess.sh --job_target=1 --task_type=text_classification --script_type=cls_cnn_ch.json
- 任务的启动总入口为normal_start_with_preprocess.sh ,这个脚本中会去判断job类型、预训模型类型、任务类型,并下载好需要下载的东西,之后调用
run_with_preprocess.py来启动对应的网络与json配置。run_with_preprocess.py是在原来的run_with_json.py的基础上添加了对交叉验证、网格搜索的预处理操作。
-
运行过程中产生的目录结构
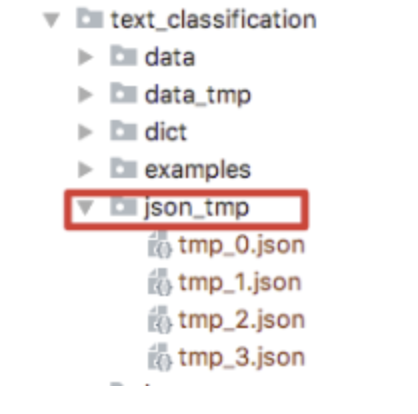
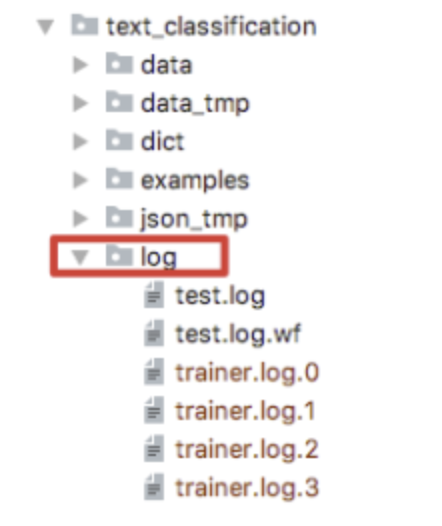
- 使用run_with_preprocess.py来使用交叉验证功能的过程中,会产生一些额外的目录,如下所示:
- data_tmp: 通过K折交叉验证处理过后的数据,如图所示就是将原始数据分成了4组,每组包含train_data 和 dev_data。

- json_tmp:交叉验证处理完成之后生成的新的待运行配置文件。
- log:基于交run_with_preprocess.py运行的任务都会生成新的json配置,每个json对应一个独立的trainer,各个trainer按照顺序串行训练,所以日志会分别输出到对应编号的log中。如下图就是串行的4个trainer的日志。日志内容和单独运行run_with_json.py输出到test.log中的日志一样。
-
文心中目前可以使用交叉验证的任务
- 可用任务:text_classification、text_generation、sequence_label、text_matching(pointwise)