


网格搜索
更新时间:2022-01-25
简介:
- 在一份配置文件中,每种超参数都可以配置一到多个值,多种超参数之间会进行排列组合,从而形成N份新的配置文件,真正运行的时候会去串行执行这N个配置文件,生成N组模型。
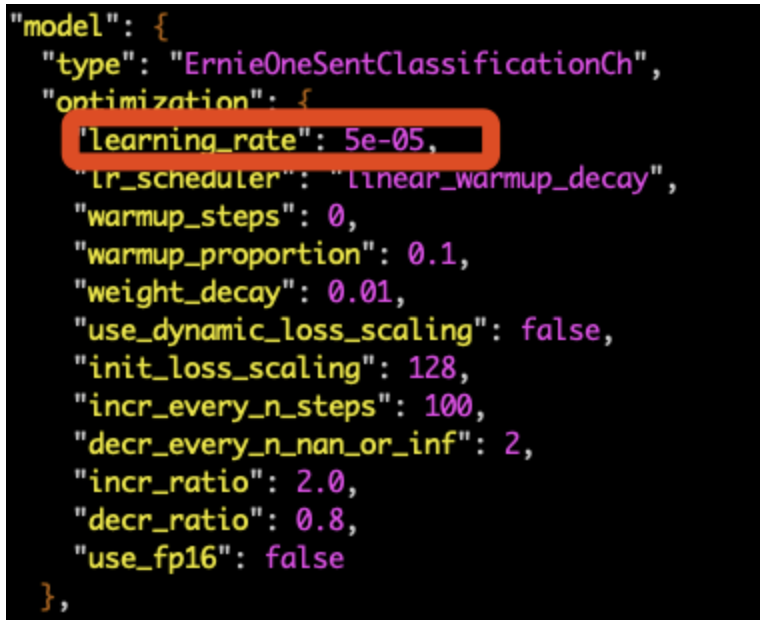
- 使用网格搜索能力选择好的超参数,以学习率为例子,如下:
-
现在想训练N个学习率不一样的模型,目前用户需要写N个配置文件,很繁琐:
- ernie_1.0_ch.Chnsenticorp.cls.json.1、
- ernie_1.0_ch.Chnsenticorp.cls.json.2、
- ernie_1.0_ch.Chnsenticorp.cls.json.3
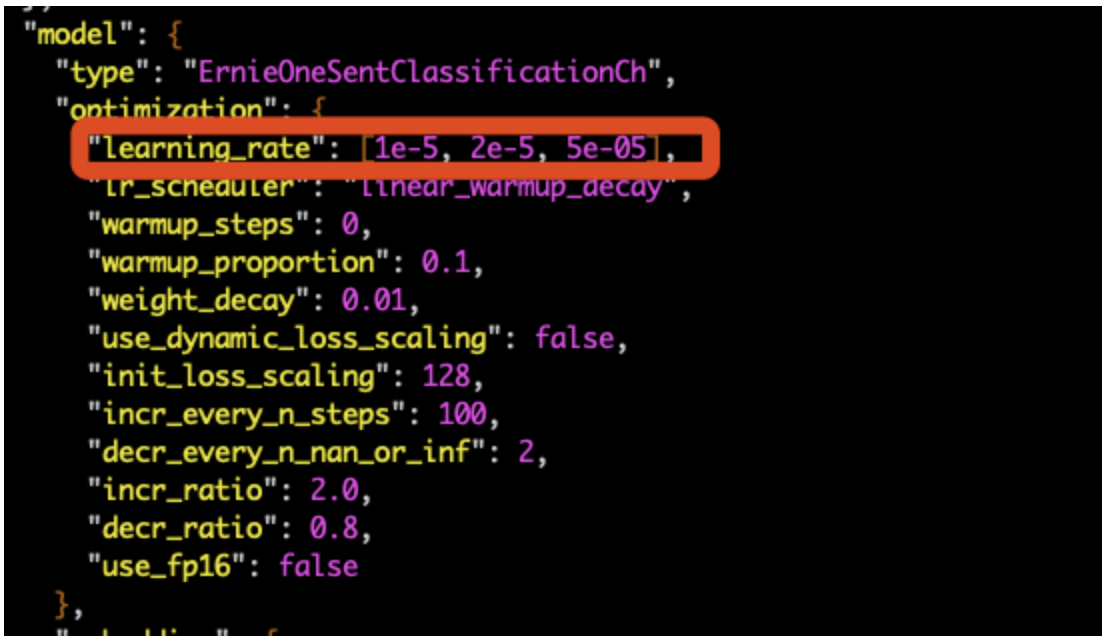
- 需求点:文心能否加一个小的配置项,支持批量提供参数,比如下图
在文心中使用网格搜索
-
json配置
- "model"中的"learning_rate"为对学习率进行网格搜索的配置,如果你需要配置多个值,用数组表示即可。目前文心的网格搜索的作用范围只在optimization 中。
- 如下所示,以CNN分类任务为例:
{ "dataset_reader": { ... }, "model": { "type": "CnnClassification", "optimization": { "learning_rate": [2e-5, 2e-4] }, "vocab_size": 33261, "num_labels": 2 }, ... } -
启动入口
- 以CNN分类任务为例:
- 启动命令:sh normal_start_with_preprocess.sh --job_target=1 --task_type=text_classification --script_type=cls_cnn_ch.json
- 任务的启动总入口为normal_start_with_preprocess.sh ,这个脚本中会去判断job类型、预训模型类型、任务类型,并下载好需要下载的东西,之后调用
run_with_preprocess.py来启动对应的网络与json配置。run_with_preprocess.py是在原来的run_with_json.py的基础上添加了对交叉验证、网格搜索的预处理操作。
-
运行过程中产生的目录结构
- 使用run_with_preprocess.py来使用网格搜索功能的过程中,会产生一些额外的目录,如下所示:
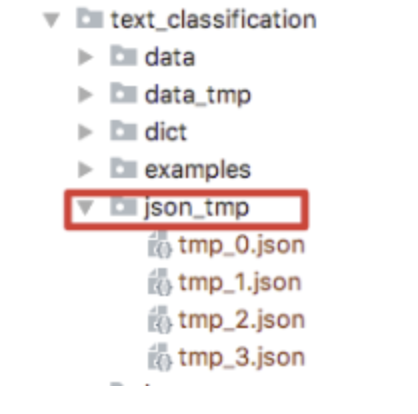
- json_tmp:网格搜索处理完成之后生成的新的待运行配置文件。
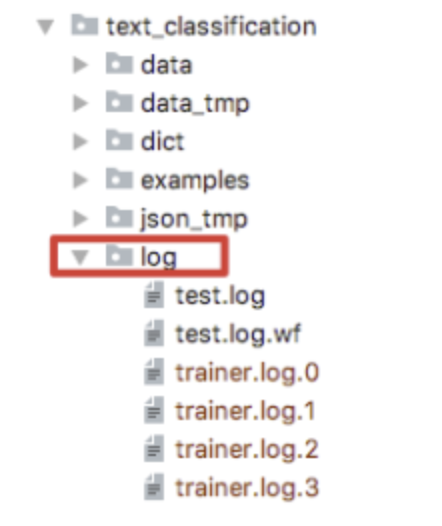
- log:基于交run_with_preprocess.py运行的任务都会生成新的json配置,每个json对应一个独立的trainer,各个trainer按照顺序串行训练,所以日志会分别输出到对应编号的log中。如下图就是串行的4个trainer的日志。日志内容和单独运行run_with_json.py输出到test.log中的日志一样。
-
文心中目前可以使用网格搜索的任务
- 可用任务:text_classification、text_generation、sequence_label、text_matching(pointwise)